Historie bijhouden op Azure Data Factory: waarom dat omvalt bij honderden tabellen
Historie bijhouden betekent dat een datawarehouse nooit een waarde overschrijft: elke wijziging wordt een nieuwe versie, terwijl de oude versie blijft staan met de periode waarin hij gold. In vakjargon heet dat SCD2. Voor één tabel bouw je dat in Azure Data Factory in een dag, maar de moeilijkheid zit in het aantal. Een gemiddelde organisatie laadt honderden tabellen, elk met een eigen sleutel, eigen kolommen en een eigen vergelijking. Dit artikel laat zien wat er per tabel bij komt kijken, waarom dat niet schaalt en hoe Yres het met één motor en metadata per tabel oplost.
Gepubliceerd: · Laatst bijgewerkt: · Door Daniel Sanders, architect van Yres en oprichter van Plainwater
Wat historie bijhouden betekent
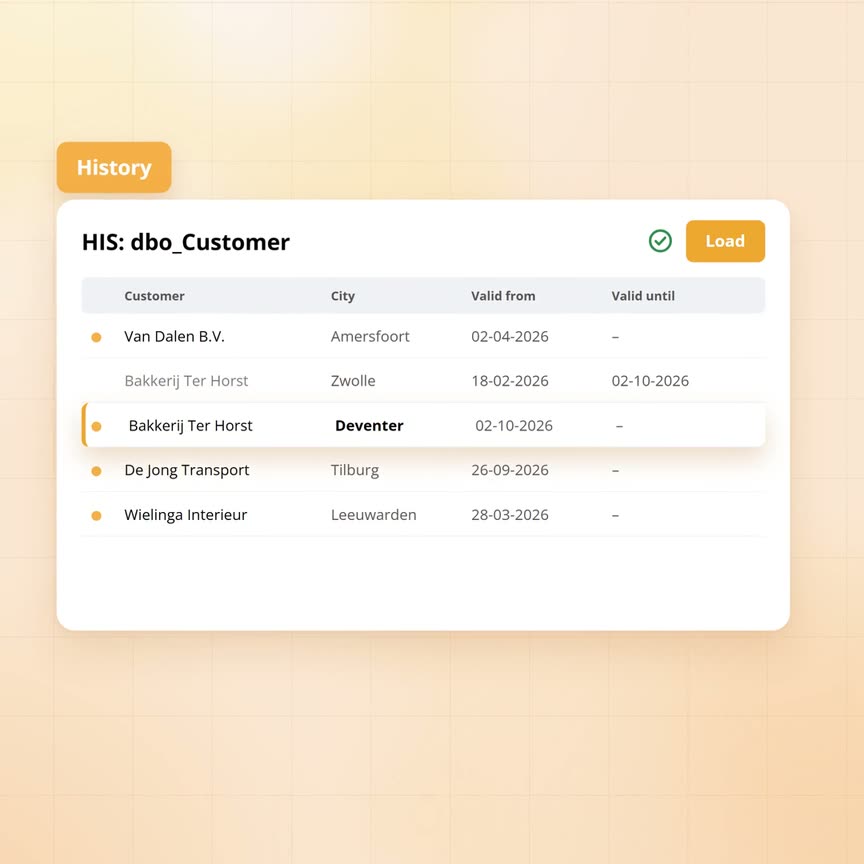
Neem een groothandel die elke nacht de klantgegevens uit het boekhoudpakket laadt. Bakkerij Ter Horst, een van die klanten, verhuist op 2 oktober van Zwolle naar Deventer. In het boekhoudpakket wordt de plaats gewoon overschreven, zodat Zwolle daar vanaf dat moment weg is. In het datawarehouse gebeurt iets anders: de rij met Zwolle wordt afgesloten met 2 oktober als einddatum en er komt een nieuwe rij bij met Deventer, geldig vanaf diezelfde dag. Beide rijen blijven bestaan.
Daardoor kun je twee soorten vragen beantwoorden. De vraag van vandaag: waar zit Bakkerij Ter Horst? Deventer. De vraag over toen: in welke plaats zat de bakkerij op 1 maart, toen die grote order werd geleverd? Zwolle. Een omzetrapport per regio over het eerste kwartaal telt de bakkerij dus bij Overijssel, ook al staat ze nu in een andere gemeente, terwijl datzelfde rapport zonder historie elke keer dat je het opent een ander antwoord zou geven.
Meer is historie bijhouden niet: per rij meerdere versies met elk een begin- en einddatum, plus per sleutel altijd één versie die de actuele is. Het idee is eenvoudig, maar de uitvoering is dat niet zodra het om meer dan een handvol tabellen gaat.
Hoe je het bouwt voor één tabel in Azure Data Factory
Azure Data Factory kopieert data van A naar B en doet dat goed. Historie bijhouden is echter iets anders dan kopiëren, dus dat bouw je er zelf omheen. Het gangbare patroon gaat zo: je kopieert de klanttabel uit het boekhoudpakket naar een tussentabel en vergelijkt daarna elke aangeleverde rij met de actuele versie in de historietabel. Dat levert per rij een van drie uitkomsten op: de klant is nieuw, de klant is gewijzigd, of er is niets veranderd. Nieuwe klanten voeg je toe, bij gewijzigde klanten sluit je de oude versie af en voeg je een nieuwe toe, terwijl ongewijzigde rijen met rust blijven.
Daar komen meteen keuzes bij. Welke kolommen bepalen of een klant dezelfde is: het klantnummer, of de combinatie van nummer en administratie? Welke kolommen tellen als wijziging: alleen de adresgegevens, of ook de datum van de laatste wijziging die het pakket zelf bijhoudt en die bij elke export anders is? Wat doe je met een klant die in het pakket is verwijderd en dus niet meer wordt aangeleverd: afsluiten, of laten staan? En telt het als gelijk wanneer twee velden allebei leeg zijn?
In Azure Data Factory kun je dit op twee manieren bouwen: met een dataflow per tabel, een grafische pijplijn die de vergelijking en het wegschrijven uitvoert, of met een kopieerstap plus een met de hand geschreven samenvoegopdracht in de database, één per tabel. Voor één tabel is dit inclusief testen een dag werk, wat een redelijke prijs is.
Waarom valt het om bij honderden tabellen?
De groothandel laadt niet één tabel. Het boekhoudpakket alleen al levert er 280: klanten, artikelen, orders, orderregels, facturen, betalingen, voorraad, leveranciers, inkoop, projecten en urenregistratie. Met het personeelssysteem, de webshop en het planningspakket erbij zijn het er 340, elk met een eigen sleutel, een eigen set kolommen en dus een eigen vergelijking. Het patroon van hierboven moet daarmee 340 keer worden gebouwd.
Het eerste wat dan gebeurt is dat de regels gaan afwijken, omdat drie ontwikkelaars in twee jaar 340 varianten van hetzelfde idee bouwen. De een sluit verdwenen rijen af, de ander niet. De een telt een lege waarde als gelijk aan een lege tekst, de ander niet. Bij de ene tabel staat de einddatum op het moment van laden, bij de andere op de datum uit de bron. Na een jaar weet niemand meer welke tabel welke regel volgt, zodat een rapport dat tabellen combineert historie krijgt die niet op elkaar aansluit.
Het tweede is de wijziging. Het boekhoudpakket krijgt in een update een nieuw veld op de klantkaart, de betalingstermijn, wat voor de klanttabel vier aanpassingen betekent: het veld toevoegen aan de tussentabel, aan de historietabel, aan de vergelijking die bepaalt of een rij gewijzigd is en aan de stap die wegschrijft. Daarna testen en uitrollen. Dat is een halve dag voor één veld in één tabel, terwijl een pakketupdate meestal tientallen tabellen tegelijk raakt.
Het derde is tijd en geld. Een dataflow in Azure Data Factory draait op een rekencluster dat per keer moet opstarten en per uur wordt afgerekend. Voor een tabel met tweehonderd rijen is die opstarttijd dezelfde als voor een tabel met twee miljoen, zodat 340 dataflows per nacht oplopen tot uren doorlooptijd waarvan de rekening niets met de hoeveelheid data te maken heeft. Met handgeschreven samenvoegopdrachten vermijd je dat, maar dan verschuift al het werk naar het onderhoud van 340 stukken code.
Het vierde is de fout halverwege. Een orderregeltabel van veertig miljoen rijen stopt om vier uur 's nachts op driekwart, omdat de database even niet bereikbaar was. Wat staat er dan in de historietabel? Bij de meeste zelfgebouwde patronen een deel van de nieuwe versies, met een deel van de oude nog open, zonder dat iets aanwijst waar het ophield. De volgende ochtend begint dan met uitzoeken in plaats van met rapporten.
Hoe Yres het doet: één motor, metadata per tabel
In Yres hoeft hetzelfde patroon geen 340 keer gebouwd te worden, want er is één motor die historie bijhoudt. Per tabel staat alleen vastgelegd wat die tabel anders maakt: welke kolommen hij heeft, welke kolommen samen de sleutel vormen en op welke manier hij geladen wordt. Elke nacht stelt de motor uit die gegevens het script voor die tabel samen en voert het uit. De regels zijn voor alle 340 tabellen dezelfde, omdat er maar één set regels is.
Wijzigingen herkent de motor met twee vingerafdrukken per rij, een van de sleutel en een van de inhoud. Zelfde sleutel met andere inhoud betekent een nieuwe versie erbij en de oude afsluiten, zelfde sleutel met zelfde inhoud betekent niets doen, terwijl een nieuwe sleutel gewoon wordt toegevoegd. Welke kolommen in de vingerafdruk van de inhoud meetellen staat per tabel in de metadata, zodat een veld dat bij elke export verandert zonder dat er iets wijzigt buiten de vergelijking blijft.
Hoe de motor met verdwenen rijen omgaat, kies je per tabel met de laadwijze, waarvan Yres er zeven kent. De belangrijkste vier zijn deze. Alleen toevoegen en versioneren, waarbij verdwenen rijen blijven staan. Alleen de wijzigingen sinds de vorige keer ophalen, met het watermerk dat ook in het artikel over terugdraaien centraal staat: de laatste wijzigingsdatum die de tabel van de bron heeft gezien. Een volledige momentopname, waarbij elke rij die niet meer wordt aangeleverd als vervallen wordt afgesloten met behoud van zijn historie. En de combinatie: alleen wijzigingen ophalen en verdwenen rijen afsluiten binnen de opgehaalde periode. Welke laadwijze bij welke bron past hangt af van wat de bron over verwijderingen kan vertellen, wat we in het artikel over de zeven laadwijzen uitwerken.
Grote tabellen verwerkt de motor in delen. Valt de orderregeltabel om vier uur 's nachts op driekwart stil, dan zijn de afgeronde delen compleet, is het laatste deel teruggedraaid en staat het watermerk nog op de vorige nacht. De volgende keer dat er geladen wordt, haalt Yres het verschil opnieuw op zonder dat iemand hoeft uit te zoeken waar het ophield. Een tabel met honderden kolommen vraagt daarbij geen andere behandeling dan een tabel met vijf.
En de betalingstermijn op de klantkaart? Na de pakketupdate ververs je in het beheerscherm de metadata van het boekhoudpakket, waarna Yres het nieuwe veld ziet en het toevoegt aan de historietabel. Vanaf de volgende keer dat er geladen wordt, neemt het de kolom mee in de vergelijking. Hetzelfde geldt voor de andere tientallen tabellen die de update raakte. Hoe dat in zijn werk gaat staat in het artikel over schema drift, net als wat er gebeurt als een bron een kolom hernoemt.
| Per tabel | Zelf gebouwd in Azure Data Factory | Met Yres |
|---|---|---|
| Sleutel en kolommen bepalen | Met de hand, in elke dataflow of samenvoegopdracht opnieuw | Eén keer vastleggen in de metadata; de motor leest het |
| Vergelijking en versionering | Per tabel gebouwd, met per ontwikkelaar eigen keuzes | Eén motor, dezelfde regels voor elke tabel |
| Verdwenen rijen | Per tabel bedacht, vaak vergeten | Keuze per tabel uit zeven laadwijzen |
| Nieuw veld in de bron | Vier plekken aanpassen, testen, uitrollen | Metadata verversen; de kolom loopt vanaf de volgende laadactie mee |
| Fout halverwege een grote tabel | Halve tabel, handmatig uitzoeken | Afgeronde delen staan, de rest wordt de volgende keer opnieuw opgehaald |
| Onderhoud bij 340 tabellen | 340 stukken pijplijn of code | 340 regels metadata en één motor |
Wanneer is zelf bouwen wel verstandig?
Zelf bouwen is te verdedigen in drie gevallen: bij een handvol tabellen die zelden veranderen, bij een team dat al een werkend patroon heeft en het consequent toepast, of als er een harde eis ligt om geen extra gereedschap in de omgeving te hebben. In die gevallen maken drie dingen het verschil tussen een oplossing en een probleem over twee jaar.
Schrijf de regels op voordat de eerste tabel wordt gebouwd: wat is een wijziging, wat gebeurt er met verdwenen rijen en waar komt de einddatum vandaan. Genereer de pijplijnen uit die regels in plaats van ze te kopiëren en aan te passen, want kopiëren is hoe de 340 varianten ontstaan. Test het afsluiten van oude versies apart, omdat dat het deel is dat het vaakst stilletjes fout gaat: de nieuwe versie staat erin terwijl de oude nog open staat, zodat twee jaar later elke klant twee actuele adressen blijkt te hebben.
Wie dat uitrekent voor 340 tabellen, komt meestal uit op een eigen generator met een eigen motor. Dat is wat Yres is, met als verschil dat hij al bestaat en al tegen die 340 tabellen is aangelopen.
- Zelf bouwen past bij: een handvol tabellen, een team met een bestaand en consequent toegepast patroon, of een verbod op extra gereedschap
- Dan wel: de regels vooraf opschrijven, pijplijnen genereren in plaats van kopiëren en het afsluiten van oude versies apart testen
- Yres past bij: tientallen tot honderden tabellen uit meerdere bronnen, bronnen die regelmatig van structuur veranderen, een klein team dat geen 340 pijplijnen wil onderhouden
- In beide gevallen geldt: historie die per tabel andere regels volgt, is in rapporten over meerdere tabellen niet te combineren
Veelgestelde vragen
Verlies ik historie als een rij uit de bron verdwijnt?
Nee. Afhankelijk van de laadwijze blijft de rij actueel staan of wordt hij afgesloten als vervallen, maar in beide gevallen blijven alle eerdere versies bewaard. Alleen de laadwijze die een tabel volledig vervangt gooit historie weg, wat je daarom alleen kiest voor tabellen waar historie geen betekenis heeft.
Wat gebeurt er als het laden halverwege mislukt?
Grote tabellen worden in delen verwerkt, zodat de delen die klaar waren compleet staan en het deel dat mislukte is teruggedraaid. Het watermerk schuift niet op, waardoor de volgende laadactie het verschil opnieuw ophaalt. Het monitoringscherm toont dat het laden is mislukt en dat het watermerk is blijven staan.
Kan ik per tabel afwijken van de standaardregels?
Per tabel kies je de laadwijze, de sleutelkolommen en welke kolommen meetellen als wijziging. Die keuzes staan in de metadata en gelden elke keer dat die tabel geladen wordt. Wil je een tabel eenmalig opnieuw laden, dan kun je voor die keer een andere laadwijze opgeven zonder de instelling te veranderen.
Doen temporal tables in SQL Server dit niet automatisch?
Voor een deel. Een temporal table bewaart vanzelf de oude versie zodra je een rij in die tabel wijzigt of verwijdert, met het tijdstip waarop de database dat deed. Het vergelijken blijft echter jouw werk: welke aangeleverde rijen zijn nieuw, welke gewijzigd, welke verdwenen en welke kolommen tellen mee. Schrijf je elke nacht alle rijen opnieuw weg, dan krijgt elke rij elke nacht een nieuwe versie, ook als er niets veranderde, zodat de moeilijke helft uit dit artikel blijft staan. Daar komt bij dat de historie niet te corrigeren is zolang de versionering aanstaat en dat rapportagetools de aparte vraagvorm voor terugkijken niet kennen. Voor een handvol tabellen waarin de wijzigingen al in de database zelf plaatsvinden is het een goede keuze, als laadmotor voor honderden brontabellen niet.
Moet ik de historietabellen zelf ontwerpen?
Nee. Yres leest de structuur van de bron en legt die vast als metadata. Daaruit maakt het de tussentabel en de historietabel aan, met de vaste kolommen voor begindatum, einddatum, actueel-markering en de twee vingerafdrukken. Verandert de bron, dan ververs je de metadata en past Yres de tabellen aan.