Microsofts metadata-driven Copy Data-patroon: tot waar het volstaat
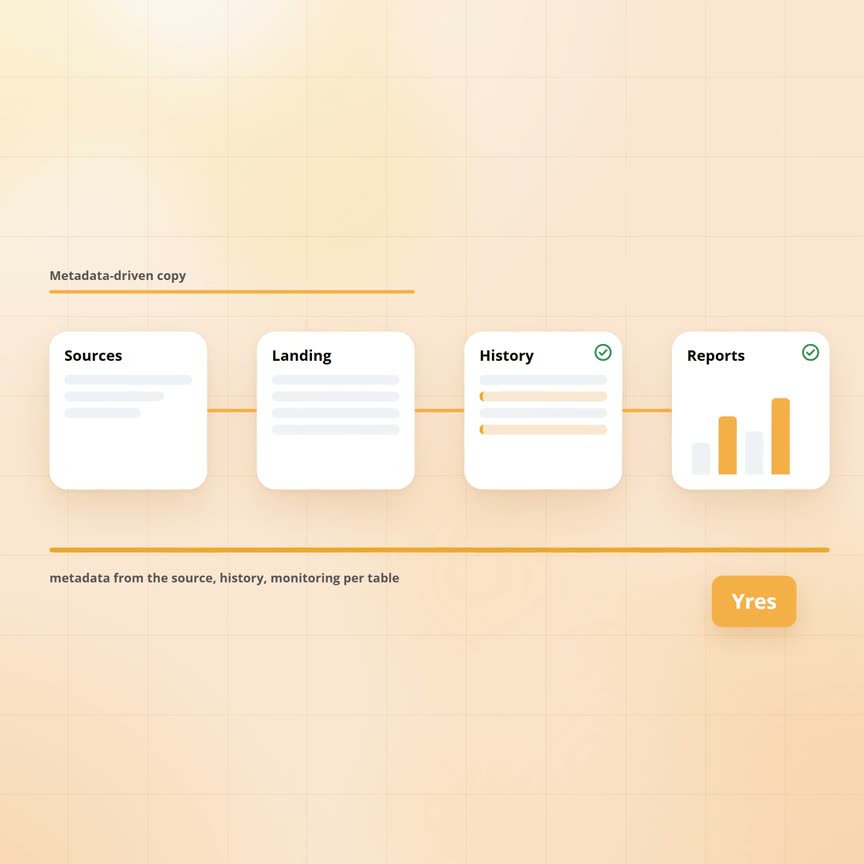
Azure Data Factory heeft een ingebouwd patroon om veel tabellen tegelijk te kopiëren zonder voor elke tabel een eigen pijplijn te bouwen: de metadata-driven Copy Data-taak. Je kiest een bron, waarna de wizard elke tabel als een regel in een besturingstabel zet en een handvol gegenereerde pijplijnen die tabel elke nacht leest en alles kopieert wat erin staat. Dat is een goed idee dat ook werkt. De vraag is wat er daarna gebeurt, want kopiëren is alleen de eerste helft van een datawarehouse, bovendien de makkelijke. Dit artikel volgt een groothandel door de eerste week met dit patroon.
Gepubliceerd: · Laatst bijgewerkt: · Door Daniel Sanders, architect van Yres en oprichter van Plainwater
Wat doet het patroon?
Sanne is de data-engineer van de groothandel. Ze opent in Azure Data Factory de Copy Data-wizard, kiest de optie voor een metadata-gestuurde kopie en wijst het boekhoudpakket aan als bron en de nieuwe database als doel. De wizard laat haar de 280 tabellen aanvinken, maakt een besturingstabel aan met per tabel één regel en genereert drie pijplijnen die samen die tabel lezen, het werk in porties verdelen en per tabel een kopie uitvoeren. Per tabel kan Sanne kiezen voor een volledige kopie of voor een kopie van alleen de rijen die sinds de vorige keer zijn gewijzigd, waarbij die laatste werkt op een wijzigingskolom waarvan de laatste waarde in de besturingstabel wordt bijgehouden. Doeltabellen die nog niet bestaan maakt de kopieerstap zelf aan.
Dat is in een middag gedaan. Dezelfde nacht staan 280 tabellen in de database en de nacht erna zijn ze bijgewerkt. Een nieuwe tabel toevoegen is één regel extra in de besturingstabel, zonder pijplijn per tabel, zonder dataflow per tabel en zonder cluster dat per tabel opstart. Voor wat het doet is het patroon goed ontworpen: het probleem van 340 varianten van dezelfde kopieerstap, dat ons artikel over historie bijhouden bij honderden tabellen beschrijft, lost het voor de kopieerstap zelf op.
Voor de kopieerstap lost het patroon dat probleem op. De rest van dit artikel gaat over wat het patroon niet doet, al is dat geen kritiek op het patroon zelf: het heet een kopieertaak en het kopieert.
De eerste week: waar het ophoudt
Dinsdag. Bakkerij Ter Horst is maandag verhuisd van Zwolle naar Deventer, dus in de gekopieerde klanttabel staat nu Deventer en is Zwolle weg. De kopie is een kopie: de tabel ziet eruit als de bron van vannacht, zonder gisteren. Het omzetrapport per regio over het eerste kwartaal telt de bakkerij vanaf nu bij Gelderland, zonder dat iemand nog kan zien dat dat vorige week anders was. Historie bijhouden, het onderwerp van ons artikel over historie bij honderden tabellen, is een stap die het patroon niet kent.
Woensdag. Een leverancier is in het boekhoudpakket verwijderd, wat op twee manieren mis kan gaan. Bij een volledige kopie verdwijnt hij stilletjes uit de doeltabel, waardoor de inkooporders die naar hem verwijzen naar niets meer wijzen. Bij een kopie van alleen de wijzigingen gebeurt het omgekeerde: een verwijderde rij wordt niet meer aangeleverd, dus de kopie ziet hem nooit en de leverancier blijft in de doeltabel staan alsof hij nog bestaat. Welke van de twee je krijgt hangt af van de keuze per tabel, maar in beide gevallen is het verkeerd.
Donderdag. De pakketupdate met de betalingstermijn op de klantkaart komt binnen. De besturingstabel kent per tabel een vaste kolomtoewijzing en de doeltabel is aangemaakt met de kolommen van maandag, zodat de nieuwe kolom niet meekomt of de kopie met een fout stopt, afhankelijk van hoe de toewijzing is ingesteld. Sanne past de regel in de besturingstabel aan en daarna de doeltabel in de database. Dat is een kwartier werk voor één tabel, terwijl de update er dertig raakte.
Vrijdag. De webshop blijkt een API te zijn in plaats van een set tabellen: ze antwoordt per pagina van honderd records, wil een toegangssleutel die elk uur verloopt en accepteert niet meer dan tien verzoeken per seconde. De kopieerstap van Azure Data Factory kan zo'n API aanroepen, maar het doorlopen van pagina's, het verversen van de sleutel en het respecteren van de limiet zijn geen regels in een besturingstabel. Dat wordt een eigen pijplijn, met de hand gebouwd, naast het patroon.
Elke ochtend is er het monitoringscherm. Om drie uur is één van de 280 kopieën mislukt, wat in het overzicht van Azure Data Factory één rode regel is tussen honderden uitvoeringen van dezelfde gegenereerde pijplijn. Welke tabel het was staat er niet bij, net zomin als sinds wanneer of welke afhankelijke tabellen nu een halve nacht missen. Sanne klikt zich door de uitvoeringen heen tot ze hem vindt.
Kopiëren is de makkelijke helft
Zet de week op een rij en er staat een lijst van wat een datawarehouse na de kopie nog nodig heeft: historie per rij, een antwoord op verwijderde rijen, een manier om een nieuwe kolom in de bron te volgen zonder handwerk per tabel en een vertaling van brontypes naar databasetypes die niet per tabel anders is. Daarbij komen nog sleutels per tabel, zodat een wijziging als wijziging herkend wordt, plus bronnen die een API met pagina's en sleutels zijn in plaats van een tabel. Tot slot een monitoring die per tabel zegt wat er is gebeurd in plaats van per pijplijnuitvoering.
Elk punt op die lijst is een beslissing per tabel. Daarmee zijn we terug bij het patroon uit het artikel over historie bijhouden bij honderden tabellen: wie het 280 keer met de hand doet, krijgt 280 varianten. De besturingstabel heeft het probleem voor de kopieerstap opgelost, maar voor alles erna ligt het er nog. Dat ligt niet aan de wizard, want een kopie houdt daar nu eenmaal op.
Hoe Yres hetzelfde idee doortrekt tot het einde
Yres gebruikt hetzelfde gereedschap. De kopie van bron naar database loopt in Yres door Azure Data Factory, in de omgeving van de klant zelf, met dezelfde kopieerstap die de wizard ook gebruikt. Het verschil zit in wat ervoor en erna gebeurt.
Ervoor: de besturingstabel vul je niet met de hand, want Yres leest zelf de structuur van de bron uit en legt die vast als metadata: tabellen, kolommen, types en sleutels. Uit die metadata maakt Yres de doeltabellen aan, met de vaste kolommen voor historie erbij. Verandert de bron, dan ververs je de metadata en worden de doeltabellen aangepast, zodat de betalingstermijn van donderdag één handeling is voor alle dertig tabellen tegelijk.
Tijdens: één orkestratie leest elke nacht uit de metadata wat er geladen moet worden en stuurt elke tabel naar de pijplijn die bij zijn brontype hoort. Voor een database is dat een rechtstreekse kopie, terwijl het voor een API zoals de webshop, of een pakket als AFAS of Exact Online, een pijplijn is die de pagina's doorloopt, de sleutel ververst en de limiet respecteert. Die pijplijnen bestaan per brontype en niet per tabel, zodat ze niet in een besturingstabel staan die iemand moet onderhouden.
Erna: zodra een tabel in de landingszone staat, neemt de motor het over die in het artikel over historie bijhouden centraal staat. Die vergelijkt met de vingerafdrukken, sluit versies af en voegt nieuwe toe, handelt verdwenen rijen af volgens de laadwijze van die tabel en schuift het watermerk op. Vóór de nacht zet Yres de database een niveau omhoog en erna weer omlaag, zodat de zware uren snel gaan zonder dat de rekening de hele dag doorloopt. Het monitoringscherm toont per tabel wat er is gebeurd, met status, duur en aantal rijen, terwijl een tijdlijn laat zien welke tabellen in welke volgorde liepen. De mislukte kopie van drie uur 's nachts is daar één rij met een tabelnaam, zonder zoektocht door uitvoeringen.
| Onderdeel | Metadata-driven Copy Data | Yres |
|---|---|---|
| Wat er geladen wordt | Besturingstabel, met de hand gevuld en onderhouden | Metadata, uit de bron zelf gelezen en te verversen |
| De kopie | Azure Data Factory, volledig of op een wijzigingskolom | Azure Data Factory, zeven laadwijzen per tabel |
| Doeltabellen | Aangemaakt als kopie van de bron | Gegenereerd uit de metadata, met de kolommen voor historie |
| Historie en verwijderde rijen | Niet; de kopie is de stand van vannacht | Versies per rij, verwijderingen volgens de laadwijze |
| Nieuwe kolom in de bron | Regel en doeltabel per tabel aanpassen | Metadata verversen, voor alle geraakte tabellen tegelijk |
| API-bronnen met pagina's en sleutels | Eigen pijplijn naast het patroon | Pijplijn per brontype, gestuurd uit dezelfde metadata |
| Monitoring | Per pijplijnuitvoering | Per tabel, met status, duur, aantallen en tijdlijn |
Wanneer is het patroon genoeg?
Er zijn situaties waarin de kopie het hele verhaal is en de wizard dus de juiste keuze. Denk aan een landingszone in een data lake die alleen de ruwe stand van elke nacht hoeft te bevatten, een eenmalige migratie van de ene database naar de andere, een archief waarin de bron één keer per maand wordt vastgelegd, of bronnen die uitsluitend databases en bestanden zijn, zonder API's. Het gaat steeds om gevallen waarin niemand ooit zal vragen hoe het vorige week was.
Zodra er een rapport op moet draaien dat ook over vorige maand klopt, komt de tweede helft erbij. Wie met de wizard begint, bouwt die tweede helft daarna per tabel met de hand, wat het verhaal is van ons artikel over historie bijhouden bij honderden tabellen. Wie weet dat die tweede helft eraan komt, kan beter beginnen met iets dat beide helften al heeft.
- Genoeg: landingszone of data lake met alleen de ruwe nachtstand, eenmalige migratie, periodiek archief, alleen databases en bestanden als bron
- Niet genoeg: rapporten die over het verleden moeten kloppen, bronnen die rijen verwijderen, bronnen die van structuur veranderen, API-bronnen met pagina's en sleutels
- In beide gevallen loopt de kopie zelf in Azure Data Factory, ook bij Yres; het verschil zit in wat ervoor en erna gebeurt
Veelgestelde vragen
Kan ik het Copy Data-patroon gebruiken en daarachter zelf historie bouwen?
Ja, veel teams doen dat. De kopie landt in een tussentabel, waarachter per tabel een vergelijking komt die versies bijhoudt. Dat werkt voor een handvol tabellen, maar bij honderden levert het de 340 varianten op uit het artikel over historie bijhouden bij honderden tabellen, omdat elke vergelijking per tabel met de hand wordt gebouwd en onderhouden.
Gebruikt Yres zelf Azure Data Factory?
Ja. De kopie van bron naar database loopt bij Yres door Azure Data Factory in de omgeving van de klant, met dezelfde kopieerstap. Yres levert daarbovenop de metadata die bepaalt wat er geladen wordt, de pijplijnen per brontype en de motor die na de kopie de historie bijhoudt, zodat wie al met Azure Data Factory werkt in dezelfde omgeving blijft.
Werkt het patroon met API's zoals AFAS, Exact Online of een webshop?
De kopieerstap van Azure Data Factory kan een API aanroepen, maar het doorlopen van pagina's, het verversen van toegangssleutels en het respecteren van verzoeklimieten staan niet in de besturingstabel, zodat dat per bron een eigen pijplijn wordt. Yres heeft voor zulke bronnen een pijplijn per brontype, die uit dezelfde metadata wordt gestuurd als de databasebronnen.
Wat gebeurt er in het patroon als een bron een kolom toevoegt?
De besturingstabel kent per tabel een vaste kolomtoewijzing en de doeltabel is aangemaakt met de kolommen van het moment van inrichten. De nieuwe kolom komt daardoor niet mee, of de kopie stopt met een fout, afhankelijk van de instelling; in beide gevallen is het handwerk per tabel. Bij Yres ververs je de metadata van de bron, waarna de doeltabellen van alle geraakte tabellen worden aangepast.